理解当前画面
识别展品、纹饰、材质和用户关注的局部。
AI CULTURAL GUIDE · INCUBATING
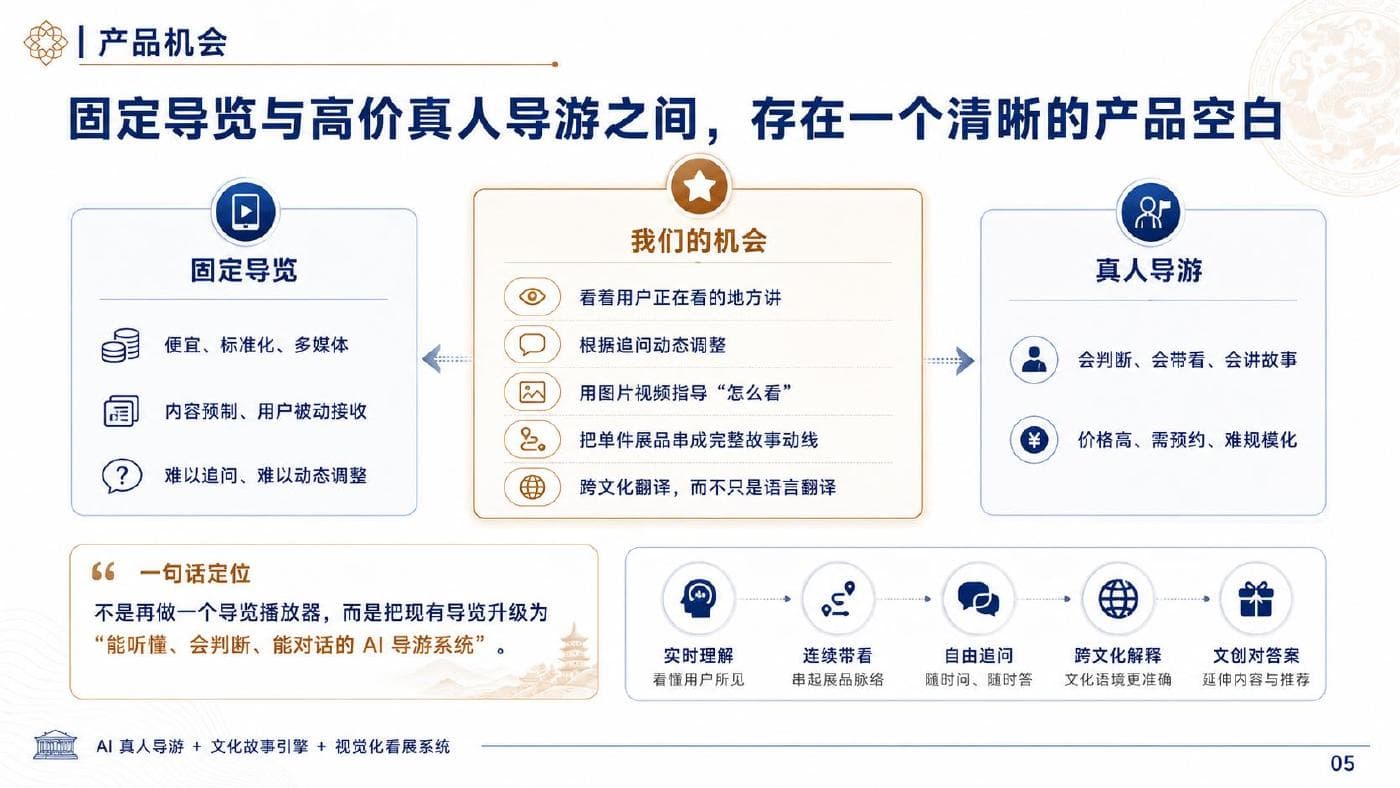
它不只复述出土年份和朝代,而是先理解用户的语言、文化背景与兴趣,再选择用户熟悉的叙事入口。喜欢影视,就关联相近的角色、场景与故事;喜欢游戏或二次元,就从装备、世界观和人物关系切入,最后把好奇心带回真实文物与历史。
展签通常只能回答“它是什么”,普通 AI 容易给出泛化答案,真人导游又需要预约和跟团。用户真正的困惑发生在眼前的细节里,需要系统看见、判断,并沿着问题继续解释。
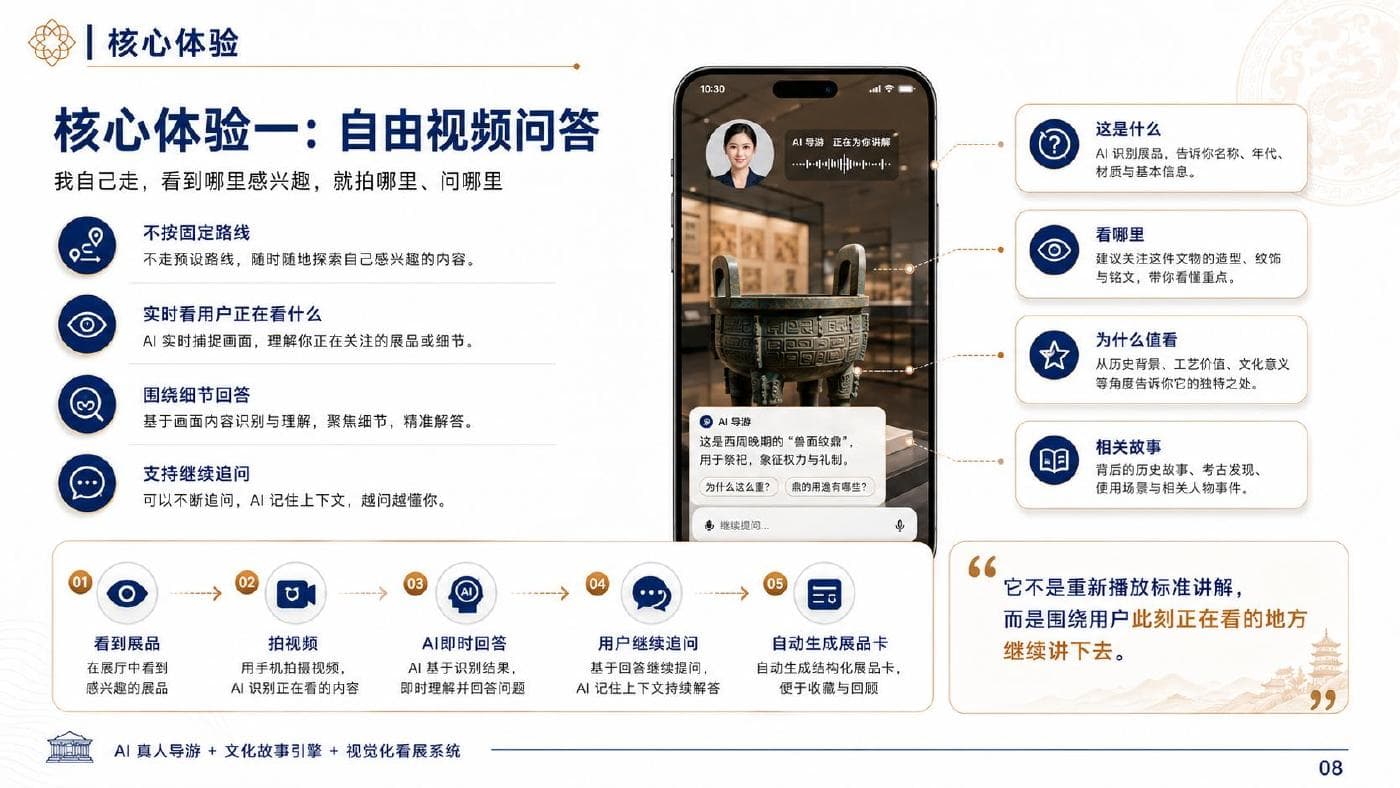
用户不必遵循固定路线。拍摄正在看的展品,AI 识别画面焦点,回答“这是什么、看哪里、为什么值得看”,并保留上下文承接后续追问。
识别展品、纹饰、材质和用户关注的局部。
记住前文,让问题逐步深入,而不是每次重新开始。
把单件展品串成故事,并连接相关文物与文创内容。
系统先识别用户主动选择的兴趣标签,也从对话、语言与追问中持续修正理解;再把可靠知识重组为更熟悉的叙事,而不是套用一份固定解说词。
关联相近的影视场景、人物处境与礼制细节,解释哪些来自历史、哪些是创作改编。
从装备属性、阵营关系与世界观进入,再还原器物真实用途和时代制度。
借助角色设定、服饰语言和叙事母题,建立陌生文化与熟悉审美之间的桥。
从身份、等级、协作和权力关系切入,理解礼制如何塑造人的行为。
从材质、工艺、审美和身份象征切入,理解古人为何制作、使用并珍视它。
直接展开年代、制度、工艺、考古证据与历史争议,形成完整知识结构。
兴趣负责打开入口,AI 负责动态组织讲法,可靠知识负责把用户带回真实历史。
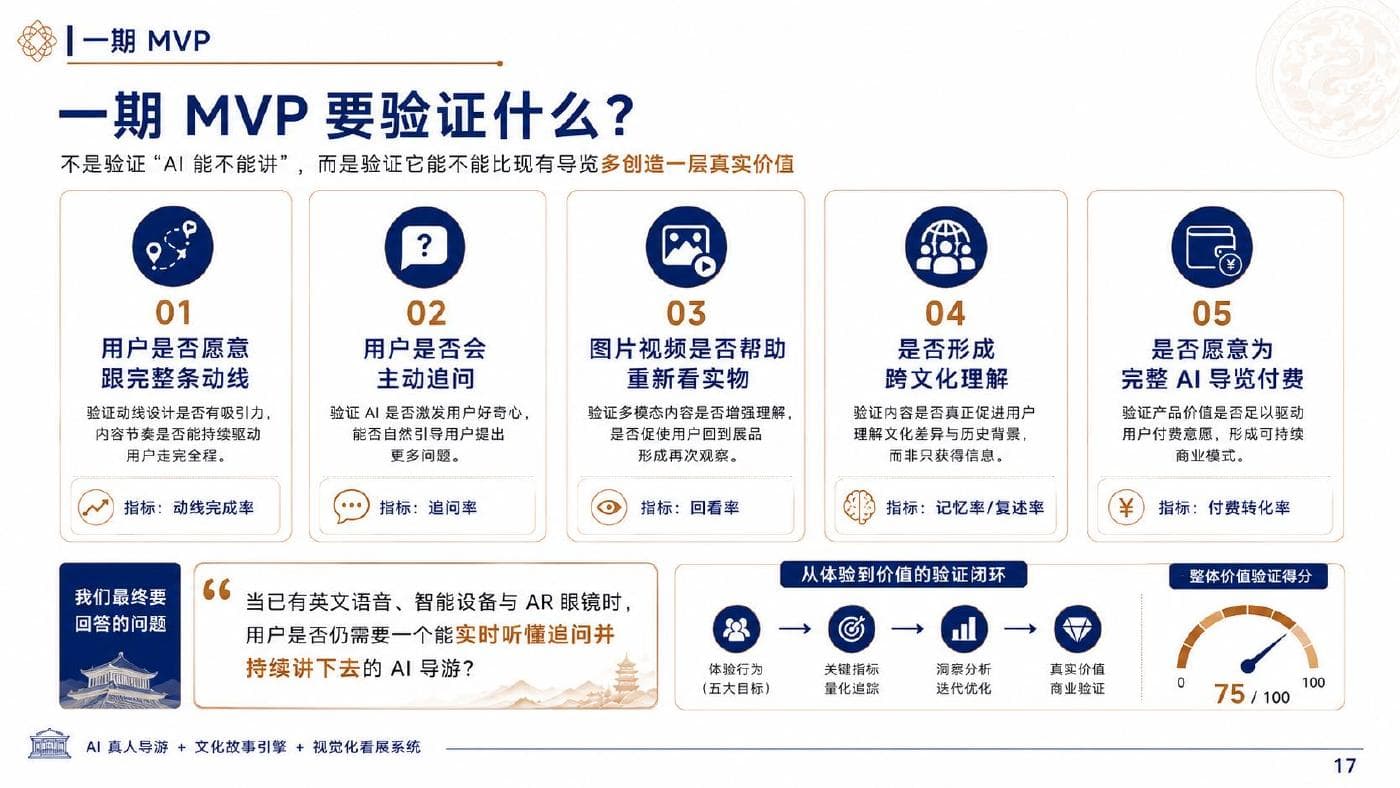
重点观察用户是否愿意跟随完整动线、主动追问、回看辅助内容、形成跨文化理解,并愿意为持续陪看付费。